始于一个问题的领域
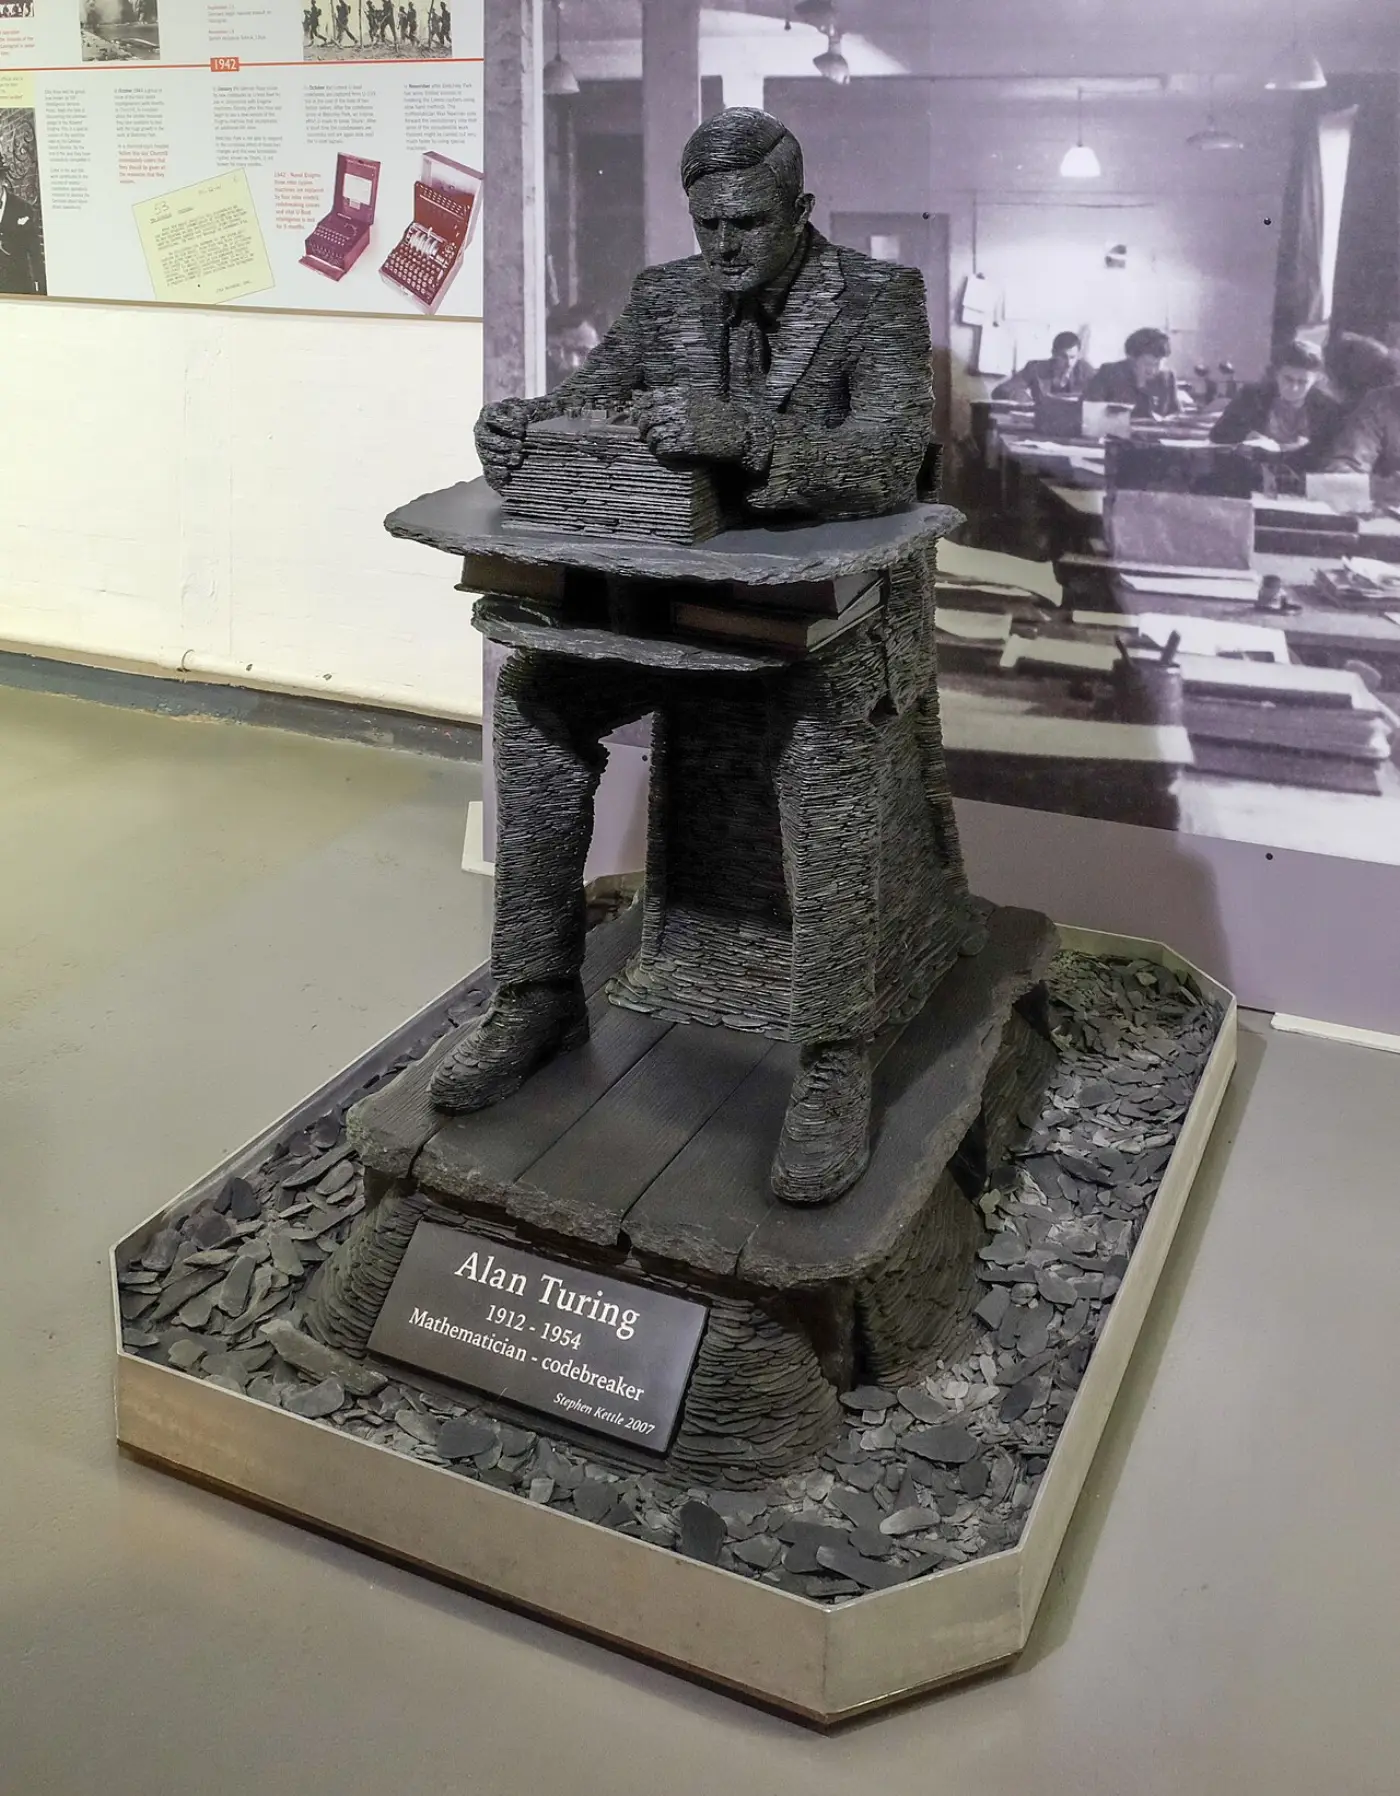
人工智能的历史并非始于机器,而是始于一个问题。1950年10月,英国数学家艾伦·图灵在哲学期刊《心灵》第59卷第236期上发表了论文《计算机器与智能》。论文开篇提出一个问题:“机器能思考吗?”可是,图灵很快就把这个问题放到了一边。他认为,靠定义“思考”和“机器”这两个词的含义,很难得出答案。于是,他提出了“模仿游戏”。提问者和一个看不见的对象用文字交谈,猜对方是人还是机器。图灵的想法是:如果机器成功装成了人,就不必再另外问它会不会思考。
笔者认为,这篇论文至今仍有人读,是因为它改变的不是答案,而是提问的方式。它把“会不会思考”这个内在的问题,换成了“能否与人区分开”这个外在的测试。这样一来,人们不必再围绕智能争论不休,而是可以造出机器来试一试。如今我们使用对话式AI时会觉得它“像人”。这种感觉,早在75年前的论文里就已经被写成了一种测试方法。
※ 本图由AI复原生成 · 非现场实际拍摄照片
1955年夏天,有了名字
“人工智能”一词最早出现在一份1955年8月31日的提案中。这份文件由四个人共同撰写:达特茅斯学院的约翰·麦卡锡、哈佛大学的马文·明斯基、IBM的纳撒尼尔·罗切斯特和贝尔实验室的克劳德·香农。提案建议,1956年夏天由十个人在新罕布什尔州汉诺威的达特茅斯学院用两个月时间研究人工智能。提案还用一句话写下了研究的出发点。这个假设是:学习的每个方面以及智能的其他一切特征,原则上都能被描述得非常精确,因此可以让机器来模仿。提案写道,要设法让机器使用语言、形成抽象和概念、解决目前只有人类才能解决的问题,并且能自我改进。
重读这句话,有两点引人注目。一是雄心。语言、抽象、解决问题和自我改进这四个目标,70年后的今天仍是研究的主线。二是谦逊。提案用的词是“假设”,期限是“一个夏天”。它的提议只是让十个人聚在一起,用两个月看看什么是可能的。这个领域的名字,就诞生于这样一次小小的聚会。
※ 本图由AI复原生成 · 非现场实际拍摄照片
第一个模仿说话的程序
1966年1月,麻省理工学院(MIT)的约瑟夫·魏泽鲍姆在《ACM通讯》第9卷第1期上发表了关于ELIZA的论文。ELIZA是运行在MIT分时系统MAC上的程序。人用自然语言输入句子,计算机就用自然语言回答。方法很简单。它先在输入的句子里找关键词,用“分解规则”把句子拆开,再用附在该规则上的“重组规则”生成回答。它并不是理解了对方的话,而是按照规则把话“递回去”。
论文标题本身就说明,这是一个用来研究人与机器之间“自然语言交流”的程序。所以笔者认为,ELIZA留下的教训与其说在于机器的能力,不如说在于人的反应。只要有话回过来,人就很容易觉得背后有一颗心。60年后的今天,我们使用对话式AI时,这种倾向依然在起作用。无论机器有多聪明,ELIZA都率先揭示了:我们多么容易把心思“读进”机器里。
1997年5月,计算胜过记忆的一天
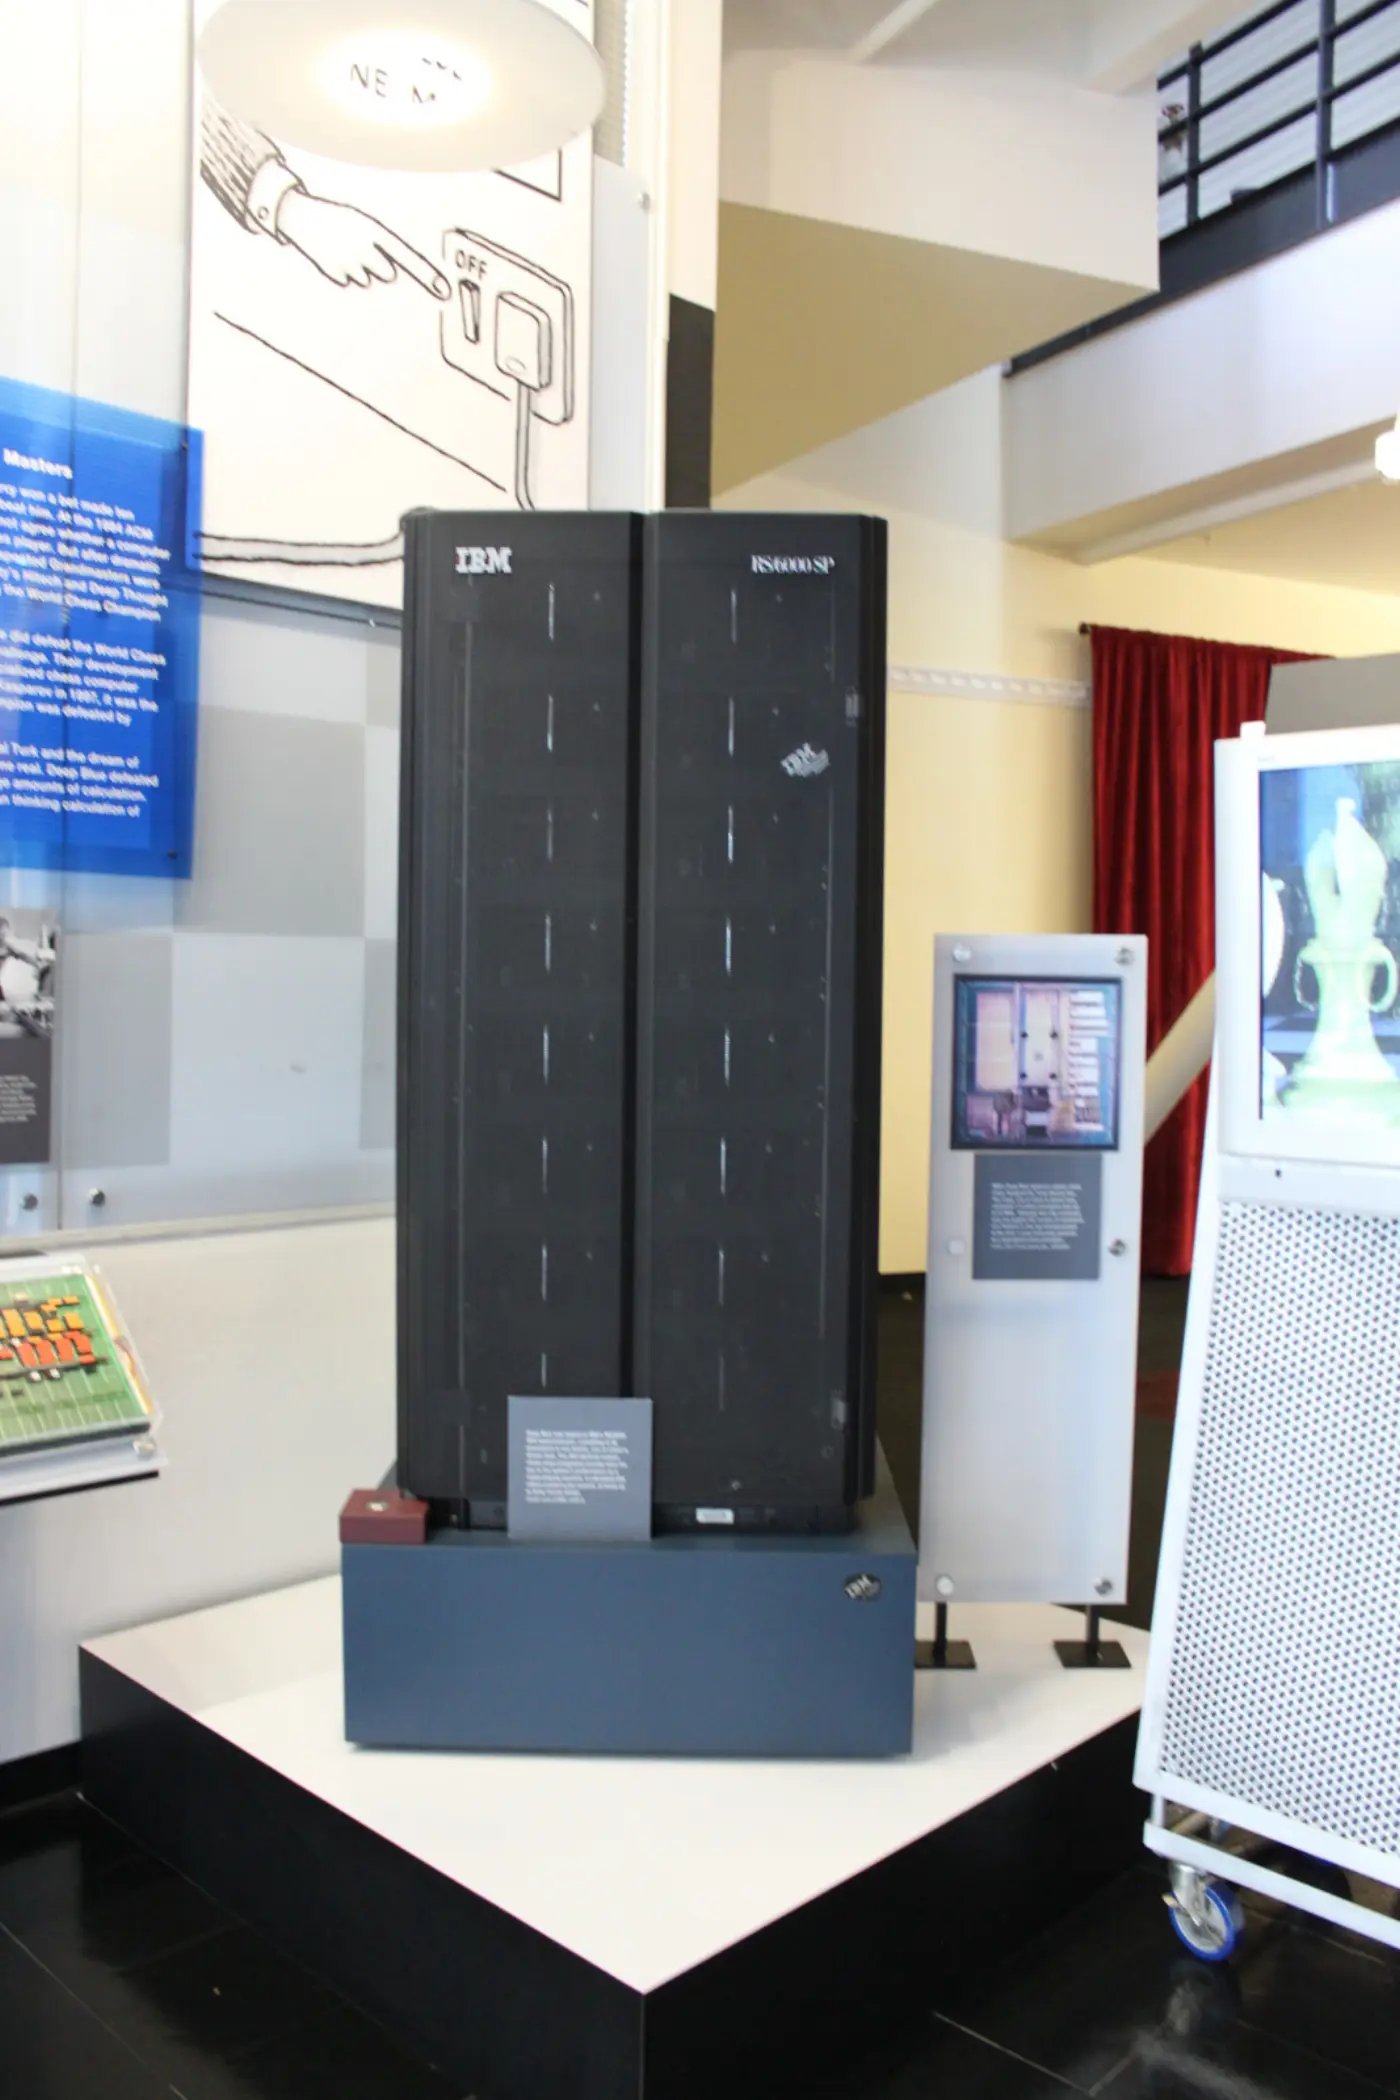
这个领域有了名字40多年后,1997年5月,在纽约,IBM的国际象棋计算机“深蓝”以3.5比2.5战胜了世界冠军加里·卡斯帕罗夫。据IBM记载,深蓝每秒能评估2亿个棋局局面。人类冠军靠记忆和直觉选棋,机器则计算并比较数不清的可能走法。
深蓝不是会“学习”的机器,而是会“计算”的机器。所以笔者认为,把这场胜利看作计算能力的胜利,比看作智能的胜利更准确。不过,这件事留下的意义是明确的。国际象棋长期被人类视为智慧的象征。在这项游戏中,人们当众确认:在既定规则之内,机器可以超越人类。
※ 本图由AI复原生成 · 非现场实际拍摄照片
2012年,机器学会了“看”
下一次转折来自学习,而不是计算。2012年,多伦多大学的亚历克斯·克里热夫斯基、伊利亚·苏茨克维和杰弗里·辛顿,用含120万张照片的ImageNet数据训练了一个深度卷积神经网络。这个网络有6,000万个参数、65万个神经元。为了加快训练,他们使用了GPU。这个模型的一个变体在当年的ILSVRC-2012竞赛中夺冠,前5候选错误率为15.3%。第二名的错误率是26.2%。
单看数字,差距是10.9个百分点,但意义远不止于此。人不必写下“猫的耳朵是尖的”这样的规则。机器看了大量照片,就能自己找出特征。这一年,这一点以巨大的差距显现出来。如今,在照片中找人脸、读医学影像、让汽车识别行人,这些技术的根源大体都可以追溯到这种方法。
2016年3月,首尔的棋盘
2016年3月9日至15日,谷歌DeepMind的AlphaGo在首尔四季酒店与李世石九段下了五局棋。结果AlphaGo以4比1获胜。李世石在3月13日的第四局中获胜,AlphaGo在那一局投子认输。据DeepMind介绍,AlphaGo使用两个神经网络。一个是选择下一步的策略网络,一个是预测谁会赢的价值网络。AlphaGo先从人类高手的数千局棋谱中学习。之后,它与旧版本的自己对弈数千局,从自己的失误中学习。
AlphaGo在计算之上加入了学习。它先向人学习,后来没有人也能学习。笔者认为,这场对局在韩国之所以特别,不在于结果本身。而在于许多人通过直播看着机器落子,第一次真切感受到“机器能做什么”。同时,第四局也表明,机器也会出错。
2017年的蓝图,2022年的对话框
2017年6月,谷歌研究团队发表了论文《Attention Is All You Need》。论文提出了Transformer架构。它完全抛弃了循环结构和卷积,只用一种叫“注意力”的机制来处理句子。在英德翻译评测中,它取得28.4 BLEU,比当时的最佳结果高出2 BLEU以上。在英法翻译中,用8块GPU训练3.5天的单个模型取得了41.8 BLEU。这一架构后来成为语言模型的基础。
2022年11月30日,OpenAI以“研究预览版”的形式发布了ChatGPT。OpenAI表示,这个模型是在2022年初完成训练的GPT-3.5系列基础上针对对话调整而成的,并采用了基于人类反馈的强化学习(RLHF)。在同一篇文章中,OpenAI也写明了局限。它有时会写出听起来合理、实则错误或荒谬的回答。同一个问题稍微换个说法,答案就会不同。它还可能回应有害的指令。这次发布之后,对话式AI走出实验室,成了日常工具。
笔者认为,这份局限清单是整篇发布文中最重要的部分。因为这是推出工具的一方亲自写下“这个工具会这样出错”。这就像在锤子说明书上写明“可能砸到手指,而不是钉子头”。使用者有没有读过这一行,决定了结果。
帮到人的场景之一:2亿个蛋白质的形状
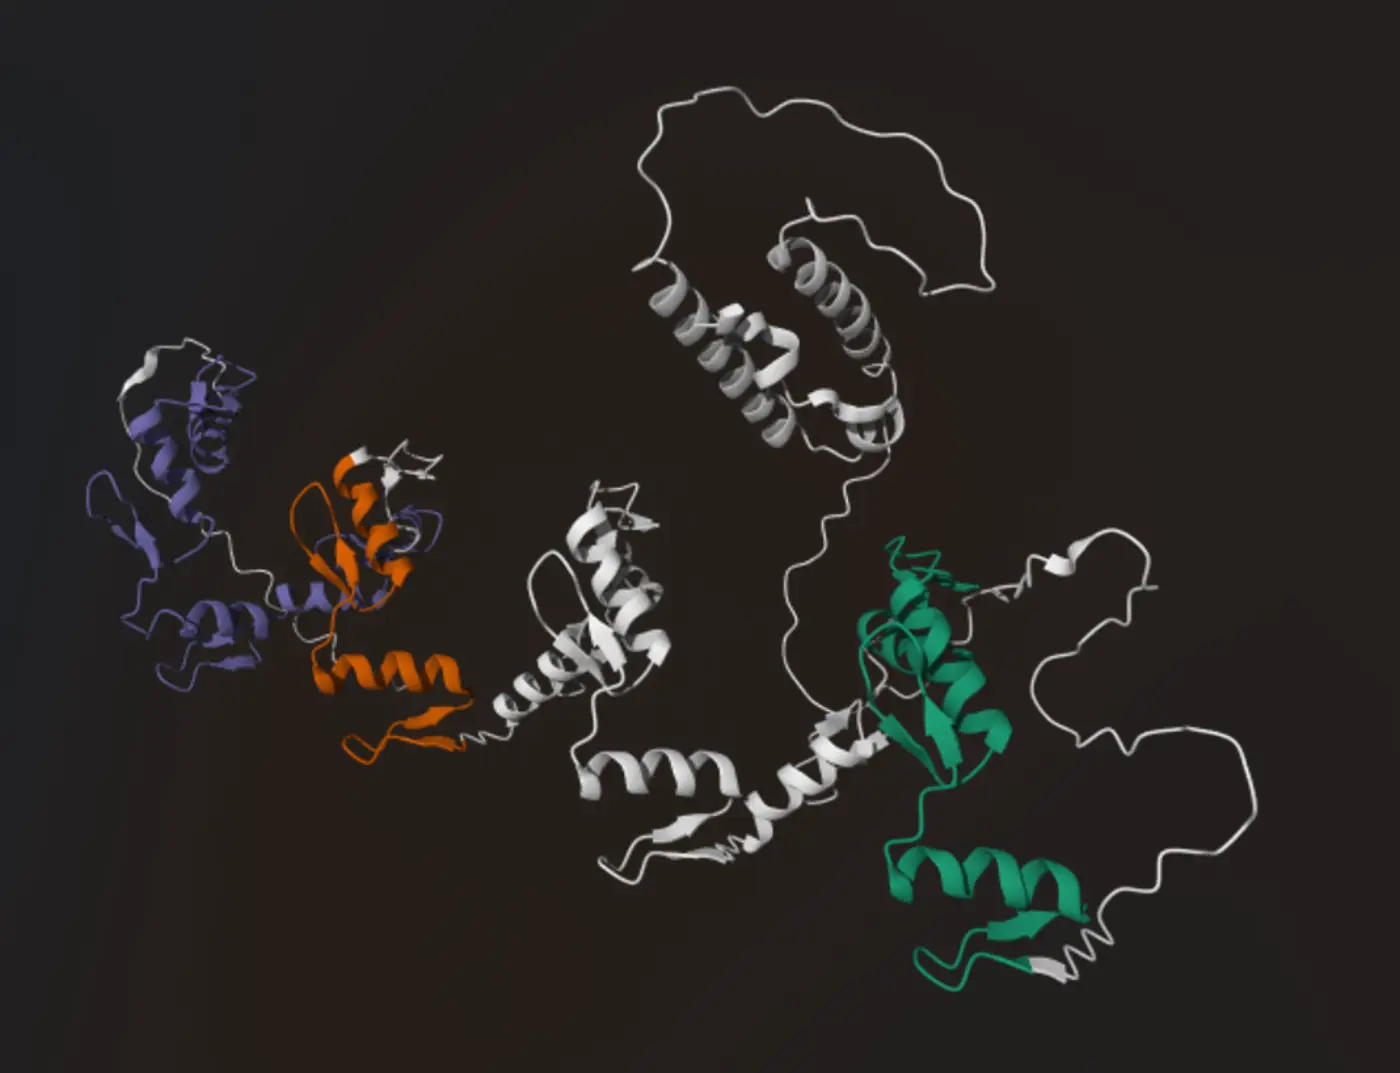
如果发展的历史只留下了游戏和对话,笔者就不会写这篇文章。2020年,DeepMind的戴密斯·哈萨比斯和约翰·江珀发布了AlphaFold2。这是一个根据氨基酸序列预测蛋白质三维结构的模型。从20世纪70年代起,研究者就一直在努力解决这个问题。2021年7月,DeepMind与欧洲分子生物学实验室(EMBL-EBI)开放了一个收录35万个预测结构的公共数据库。2022年7月,数据库扩展到2亿多个结构,几乎覆盖了所有已完成基因组测序的生物的蛋白质。这些结构以CC BY 4.0许可证向所有人开放。在宣布扩展时,已有来自190多个国家的50多万名研究者使用过该数据库。在一年多的时间里,引用它的论文超过1,000篇。
2024年10月9日,瑞典皇家科学院宣布:诺贝尔化学奖的一半授予哈萨比斯和江珀,表彰其“蛋白质结构预测”;另一半授予大卫·贝克,表彰其“计算蛋白质设计”。公告写道,AlphaFold2几乎预测了研究者已发现的约2亿种蛋白质的全部结构。来自190个国家的200多万人使用过它。它正被用于理解抗生素耐药性,以及描绘能分解塑料的酶的样貌。
这个案例对笔者来说之所以特别,是因为工具给出的不是“答案”,而是“地图”。知道了蛋白质结构,并不意味着马上就能做出药来。但是,50年来一个一个靠实验弄清的形状,如今一下子摊开了2亿个。这样,研究者就能快得多地决定该从哪里挖下去。好的工具与其说是替人干活,不如说是让工作的起点提前。
※ 本图由AI复原生成 · 非现场实际拍摄照片
帮到人的场景之二:没有专科医生的诊室里的眼睛检查
2018年4月11日,美国食品药品监督管理局(FDA)批准了一款名为IDx-DR的软件上市。这款设备用人工智能分析糖尿病患者的视网膜照片。如果存在超过轻度的糖尿病视网膜病变,就给出“转诊眼科专科医生”;如果没有,就给出“12个月后复查”。结果只有这两种之一。FDA表示,这是首个获批的、无需临床医生另行解读影像或结果就能给出筛查结论的设备。也就是说,平时不看眼睛的初级保健医生也能使用。FDA审查的临床研究在10家初级保健机构进行,使用了900名糖尿病患者的视网膜照片。该设备正确识别出了87.4%的超过轻度病变的患者,以及89.5%的没有此类病变的患者。
FDA的公告中还附有一句说明:约一半糖尿病患者每年不去看眼科。笔者认为,这个工具的价值与其说在于准确率数字,不如说在于这句话。它让不去眼科的人,能在眼科以外的地方提前检查眼睛。同时,FDA也详细写明了不该使用的情形。不得用于孕妇、已接受过眼部治疗的患者和患有其他视网膜疾病的患者。40岁和60岁时,仍应接受全面的眼科检查。工具的用途和不该用的场合,被并排写在同一份文件里。
石器时代的石斧与今天的工具
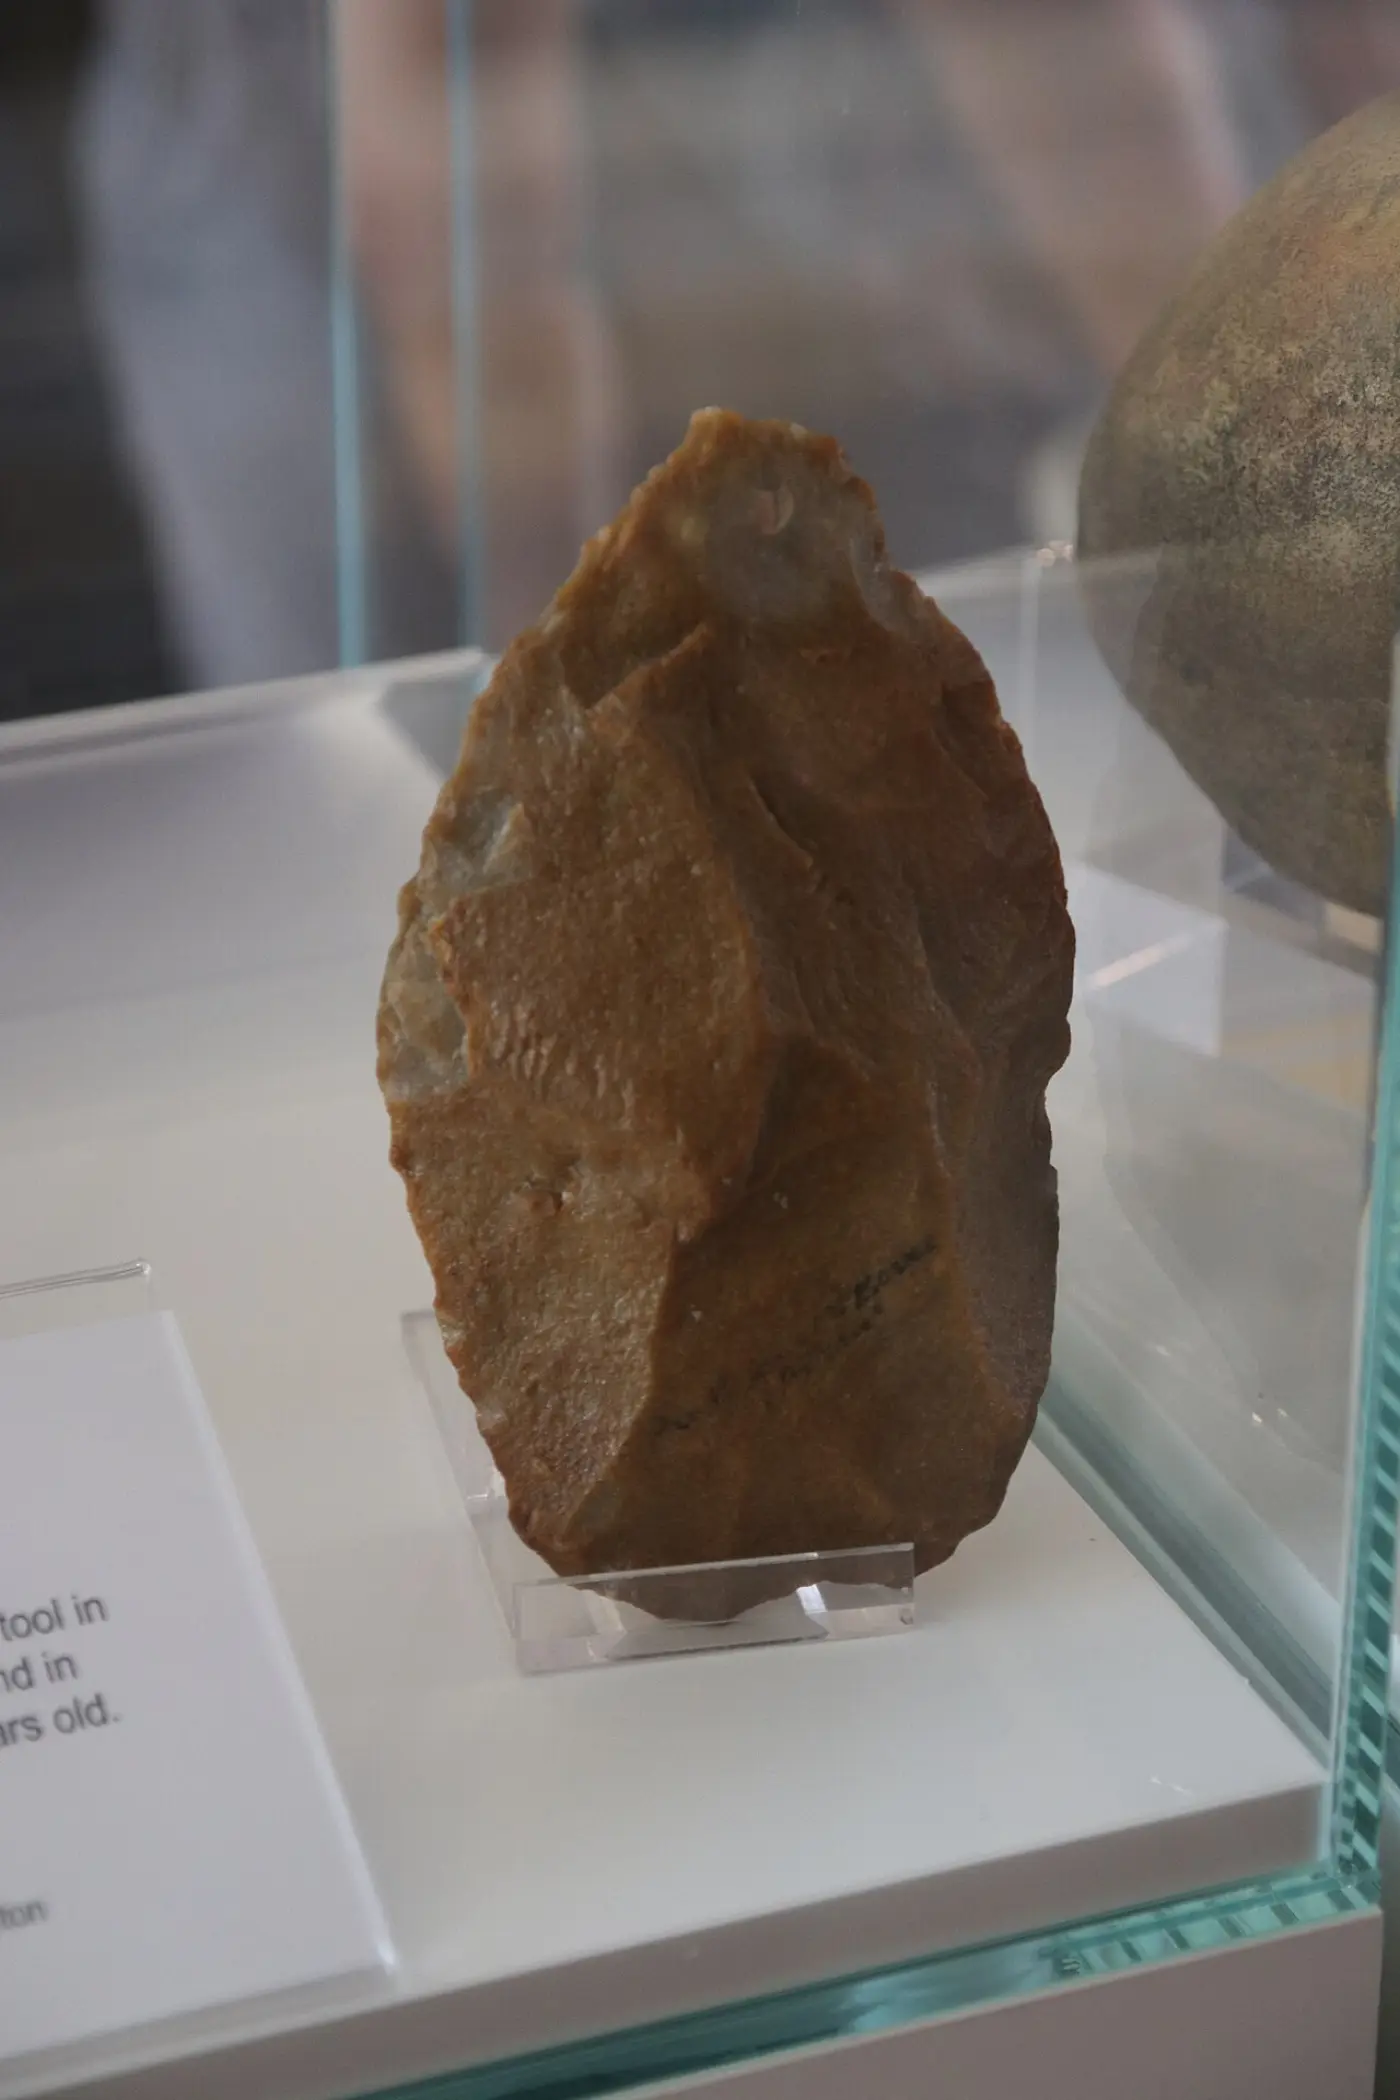
根据史密森尼国家自然历史博物馆的人类起源资料,早期人类最晚从260万年前就开始用石头制造工具。最古老的工具组合是奥杜威石器,包括石锤、留有打片痕迹的石核和锋利的石片。约176万年前出现了手斧。它是先打下大石片,再继续打下小石片来修整形状。这种阿舍利工具组合因地区不同,一直使用到40万至25万年前。也就是说,形状相似的石器延续了100多万年。
石斧本身无所谓好坏。同一天、同一块石头做了什么,决定的不是石头,而是手。笔者也把人工智能放在这条线上来看。1950年的问题、1955年的提案、1966年的规则、1997年的计算、2012年的学习、2016年的自我对弈,还有2017年的蓝图和2022年的对话框,都是人类一路打磨出可握在手中的新工具的过程。2亿个蛋白质的地图和诊室里的眼睛检查告诉我们:当这种工具按照人的目的来使用时,会发生什么。
所以,本文的结论不是对技术的预言,而是对使用者的叮嘱。工具会随着使用目的而改变。OpenAI亲自写下的局限清单,FDA写明的禁用条件,都不是在坦白工具的缺陷。它们是使用说明书。读说明书、定目的,仍然是人的事。正如260万年前握住石头的手那样,如今放在键盘上的手,决定着要用这件工具做什么。
※ 本图由AI复原生成 · 非现场实际拍摄照片