질문 하나에서 시작한 분야
인공지능의 역사는 기계가 아니라 질문에서 시작합니다. 1950년 10월, 영국의 수학자 앨런 튜링은 철학 학술지 《마인드》 59권 236호에 〈계산 기계와 지능〉이라는 논문을 실었습니다. 논문은 "기계는 생각할 수 있는가"라는 질문으로 문을 엽니다. 그런데 튜링은 곧바로 이 질문을 내려놓습니다. '생각'과 '기계'라는 말의 뜻을 정의하는 길로는 답에 이르기 어렵다고 보았기 때문입니다. 대신 그는 '흉내 게임'을 제안했습니다. 질문자가 보이지 않는 상대와 글로 대화하고, 그 상대가 사람인지 기계인지 알아맞히는 게임입니다. 기계가 사람인 척하는 데 성공한다면, 생각하느냐고 따로 묻지 않아도 된다는 것이 튜링의 생각이었습니다.
이 논문이 오늘까지 읽히는 이유는 답이 아니라 질문의 형태를 바꾼 데 있다고 봅니다. "생각하는가"라는 안쪽의 문제를 "사람과 구별되는가"라는 바깥쪽의 시험으로 바꾸면서, 지능을 두고 끝없이 논쟁하는 대신 기계를 만들어 시험해 볼 수 있게 되었습니다. 지금 우리가 대화형 AI를 쓰면서 "사람 같다"고 느끼는 바로 그 감각이, 75년 전 논문에 이미 시험 방식으로 적혀 있었던 셈입니다.
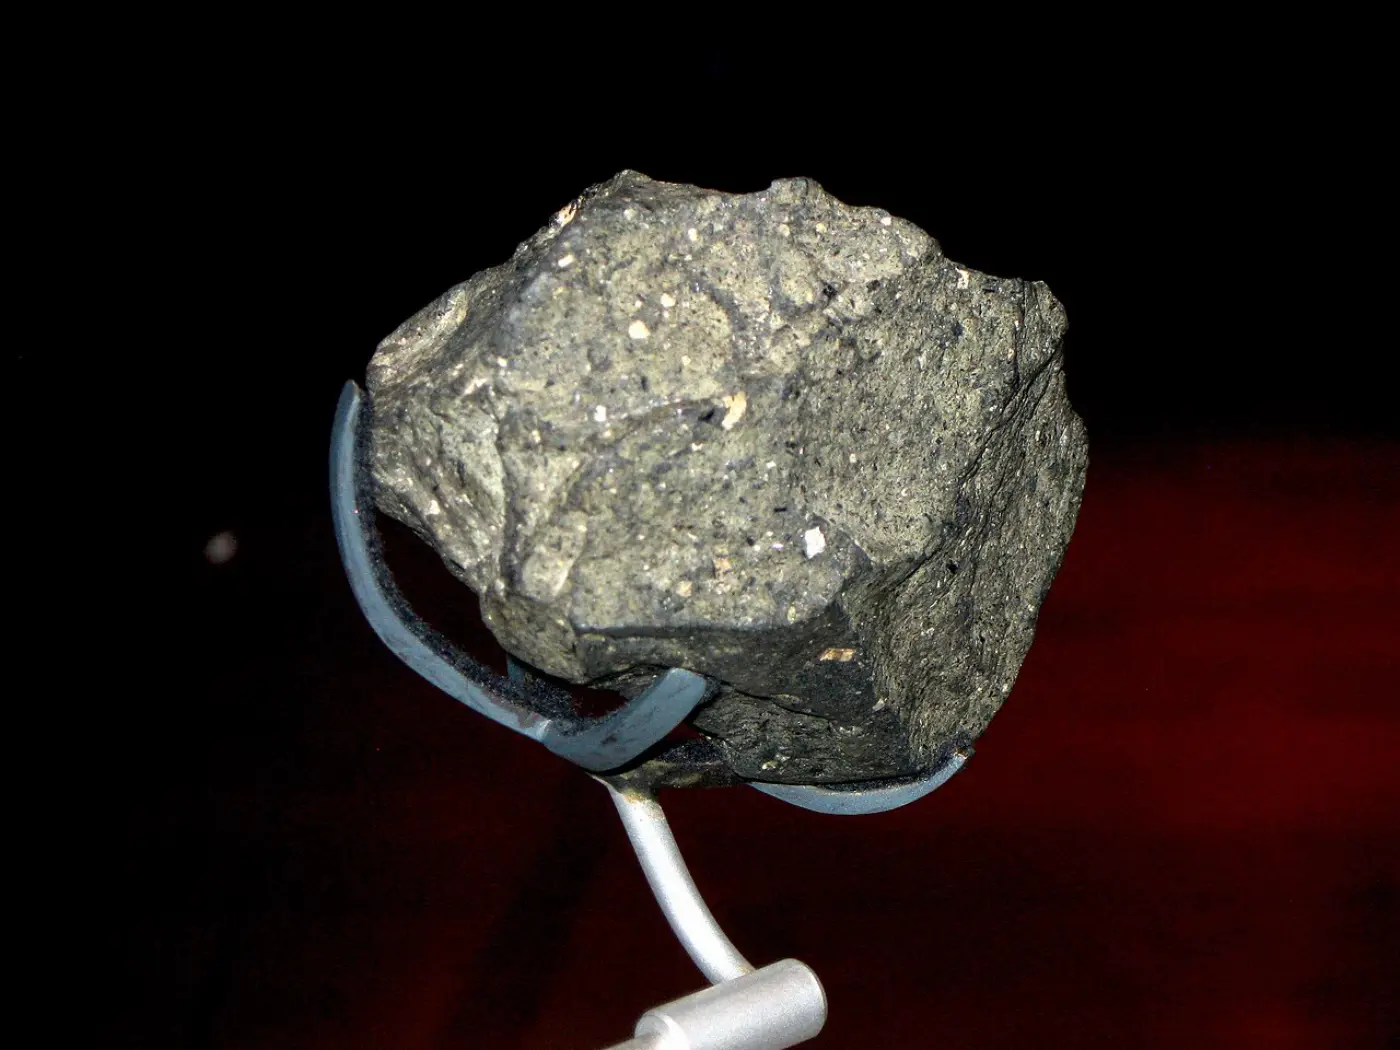
대영박물관이 소장한 올두바이 협곡의 올도완 찍개. 돌에서 격지를 떼어 낸 자국이 남아 있다 · Archaeomoonwalker · CC BY 3.0 · 위키미디어 공용
1955년 여름, 이름이 붙다
'인공지능'이라는 말은 1955년 8월 31일 자 제안서에 처음 나옵니다. 다트머스 대학의 존 매카시, 하버드 대학의 마빈 민스키, IBM의 너새니얼 로체스터, 벨 연구소의 클로드 섀넌 네 사람이 함께 쓴 문서입니다. 제안서는 1956년 여름 뉴햄프셔주 해노버의 다트머스 대학에서 두 달 동안 열 명이 인공지능을 연구하자고 제안합니다. 그리고 연구의 출발점이 될 가정을 한 문장으로 적습니다. 학습의 모든 측면과 지능의 다른 모든 특징은 원칙적으로 아주 정확하게 기술될 수 있고, 따라서 기계가 그것을 흉내 내도록 만들 수 있다는 가정입니다. 제안서는 기계가 언어를 쓰고, 추상과 개념을 만들고, 지금은 사람만 푸는 문제를 풀고, 스스로를 개선하는 방법을 찾겠다고 썼습니다.
이 문장을 다시 읽으면 두 가지가 눈에 들어옵니다. 하나는 야심입니다. 언어, 추상, 문제 풀이, 자기 개선이라는 네 가지 목표는 70년이 지난 지금도 연구의 큰 줄기입니다. 다른 하나는 겸손입니다. 제안서가 쓴 말은 '가정'이고, 기간은 '한 여름'입니다. 열 명이 두 달 동안 모여서 무엇이 가능한지 살펴보자는 제안이었습니다. 분야의 이름은 그렇게 작은 모임에서 태어났습니다.
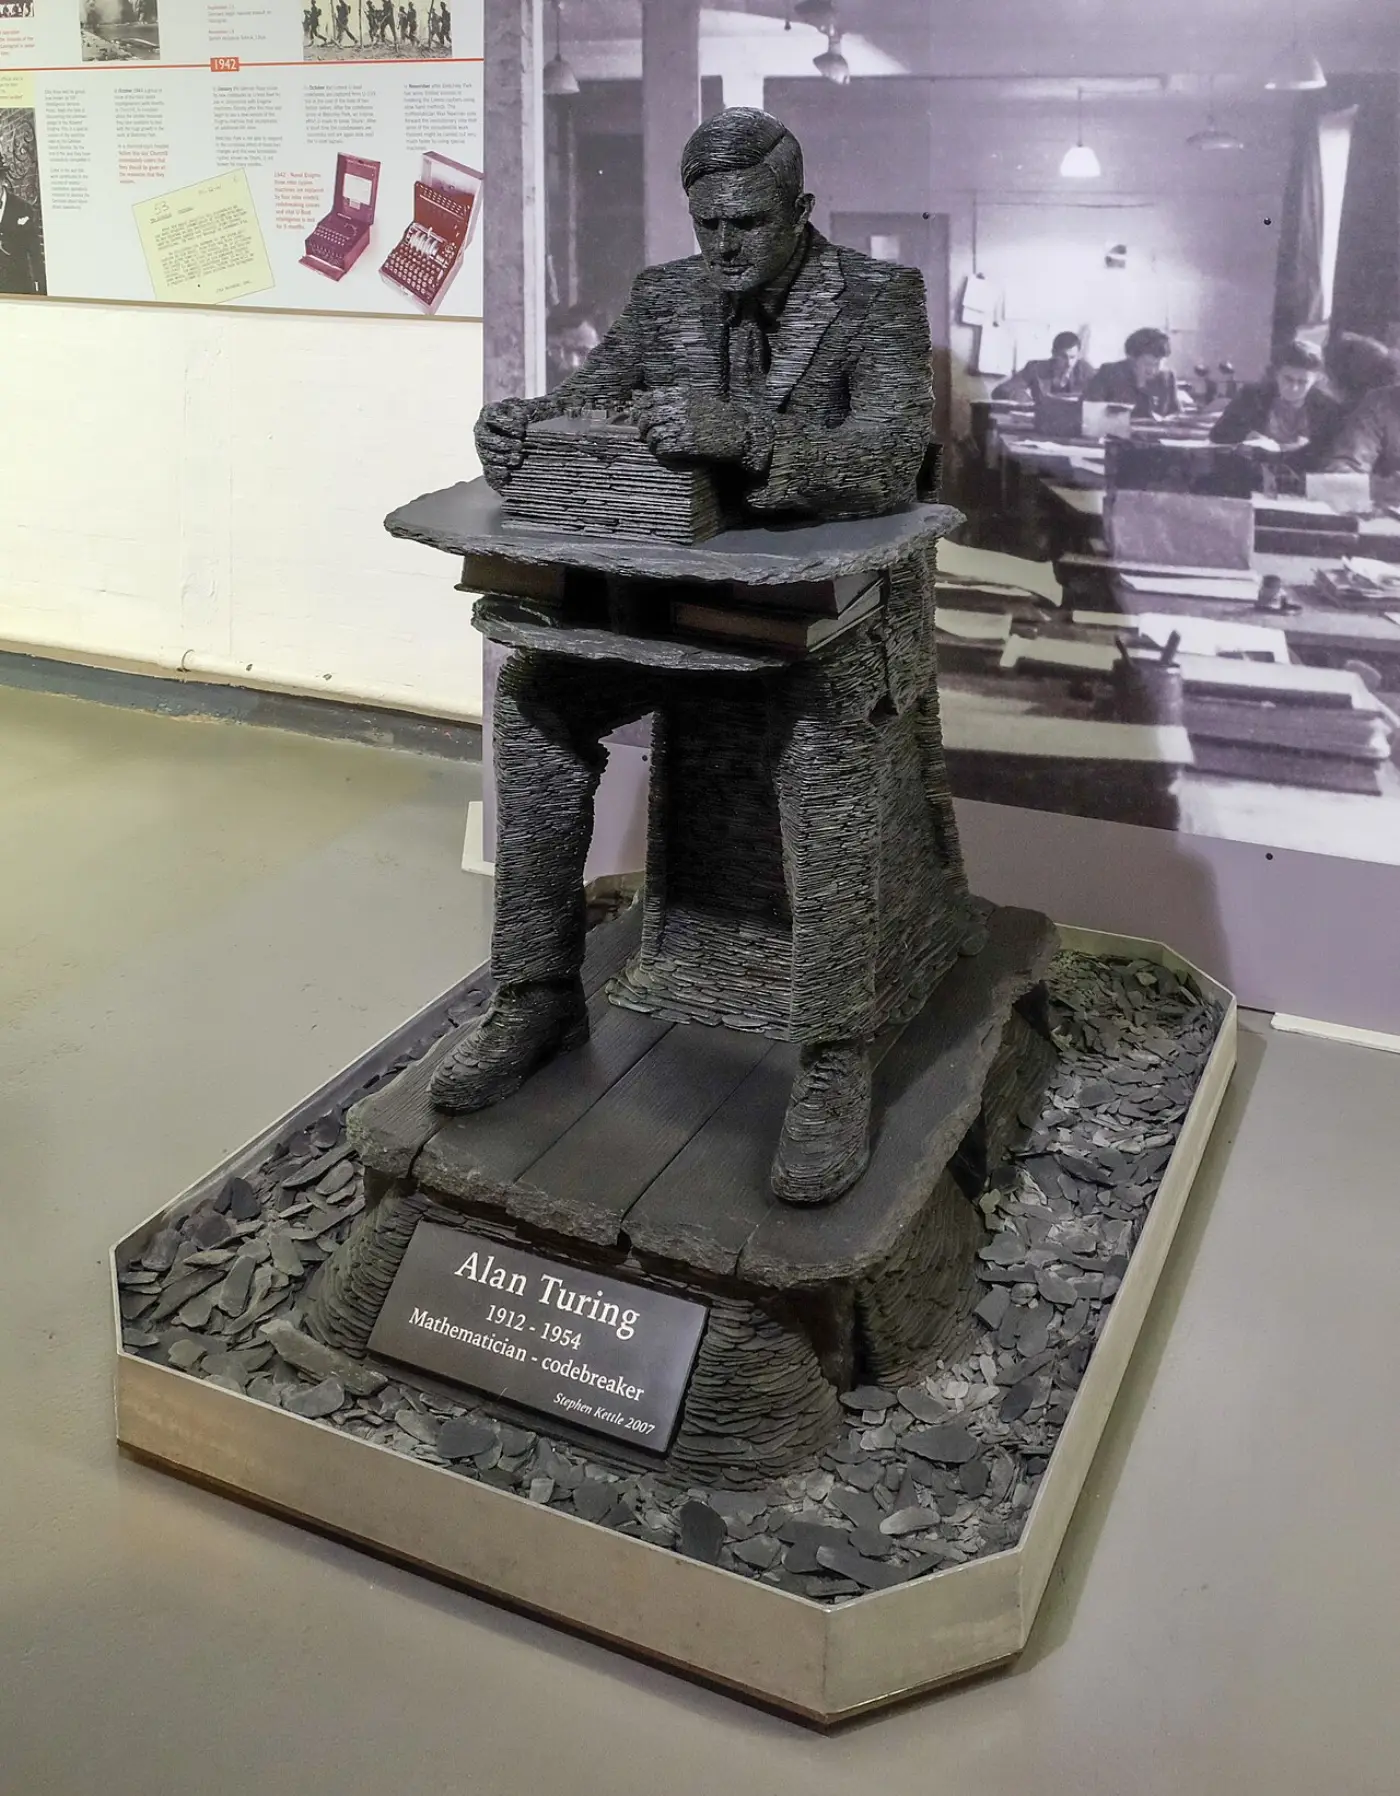
블레츨리 파크 박물관에 있는 앨런 튜링의 슬레이트 조각상(스티븐 케틀 작, 2007) · DeFacto · CC BY-SA 4.0 · 위키미디어 공용
말을 흉내 낸 첫 프로그램
1966년 1월, MIT의 조지프 바이첸바움은 《커뮤니케이션스 오브 더 ACM》 9권 1호에 ELIZA 논문을 발표했습니다. ELIZA는 MIT의 시분할 시스템 MAC 위에서 돌아가는 프로그램으로, 사람이 자연어로 문장을 치면 컴퓨터가 자연어로 답했습니다. 방법은 단순했습니다. 입력 문장에서 핵심어를 찾아 '분해 규칙'으로 문장을 쪼개고, 그 규칙에 붙은 '재조립 규칙'으로 답을 만들어 냈습니다. 상대의 말을 이해해서가 아니라, 규칙에 따라 말을 되돌려 주는 방식이었습니다.
논문 제목 자체가 사람과 기계 사이의 '자연어 소통'을 연구하기 위한 프로그램이라고 밝히고 있습니다. 그래서 ELIZA가 남긴 교훈은 기계의 능력보다 사람의 반응 쪽에 있었다고 생각합니다. 사람은 말이 돌아오면 그 뒤에 마음이 있다고 느끼기 쉽습니다. 이 성향은 60년 뒤 오늘의 대화형 AI를 쓸 때도 그대로 작동합니다. 기계가 얼마나 똑똑한지와 별개로, 우리가 기계에 얼마나 쉽게 마음을 읽어 넣는지를 ELIZA가 먼저 보여 주었습니다.
1997년 5월, 계산이 기억을 이긴 날
이름이 생기고 40년 넘게 지난 1997년 5월, 뉴욕에서 IBM의 체스 컴퓨터 딥블루가 세계 챔피언 가리 카스파로프를 3.5 대 2.5로 이겼습니다. IBM은 딥블루가 1초에 2억 개의 체스 국면을 평가할 수 있었다고 기록합니다. 사람 챔피언이 기억과 직관으로 수를 고르는 동안, 기계는 가능한 수를 셀 수 없이 많이 계산해 비교했습니다.
딥블루는 '배우는' 기계가 아니라 '계산하는' 기계였습니다. 그래서 이 승리는 지능의 승리라기보다 계산력의 승리로 읽는 편이 정확하다고 봅니다. 그러나 이 사건이 남긴 것은 분명합니다. 사람이 오랫동안 지성의 상징으로 여겨 온 게임에서, 기계가 정해진 규칙 안에서는 사람을 넘어설 수 있다는 사실이 공개된 자리에서 확인되었습니다.
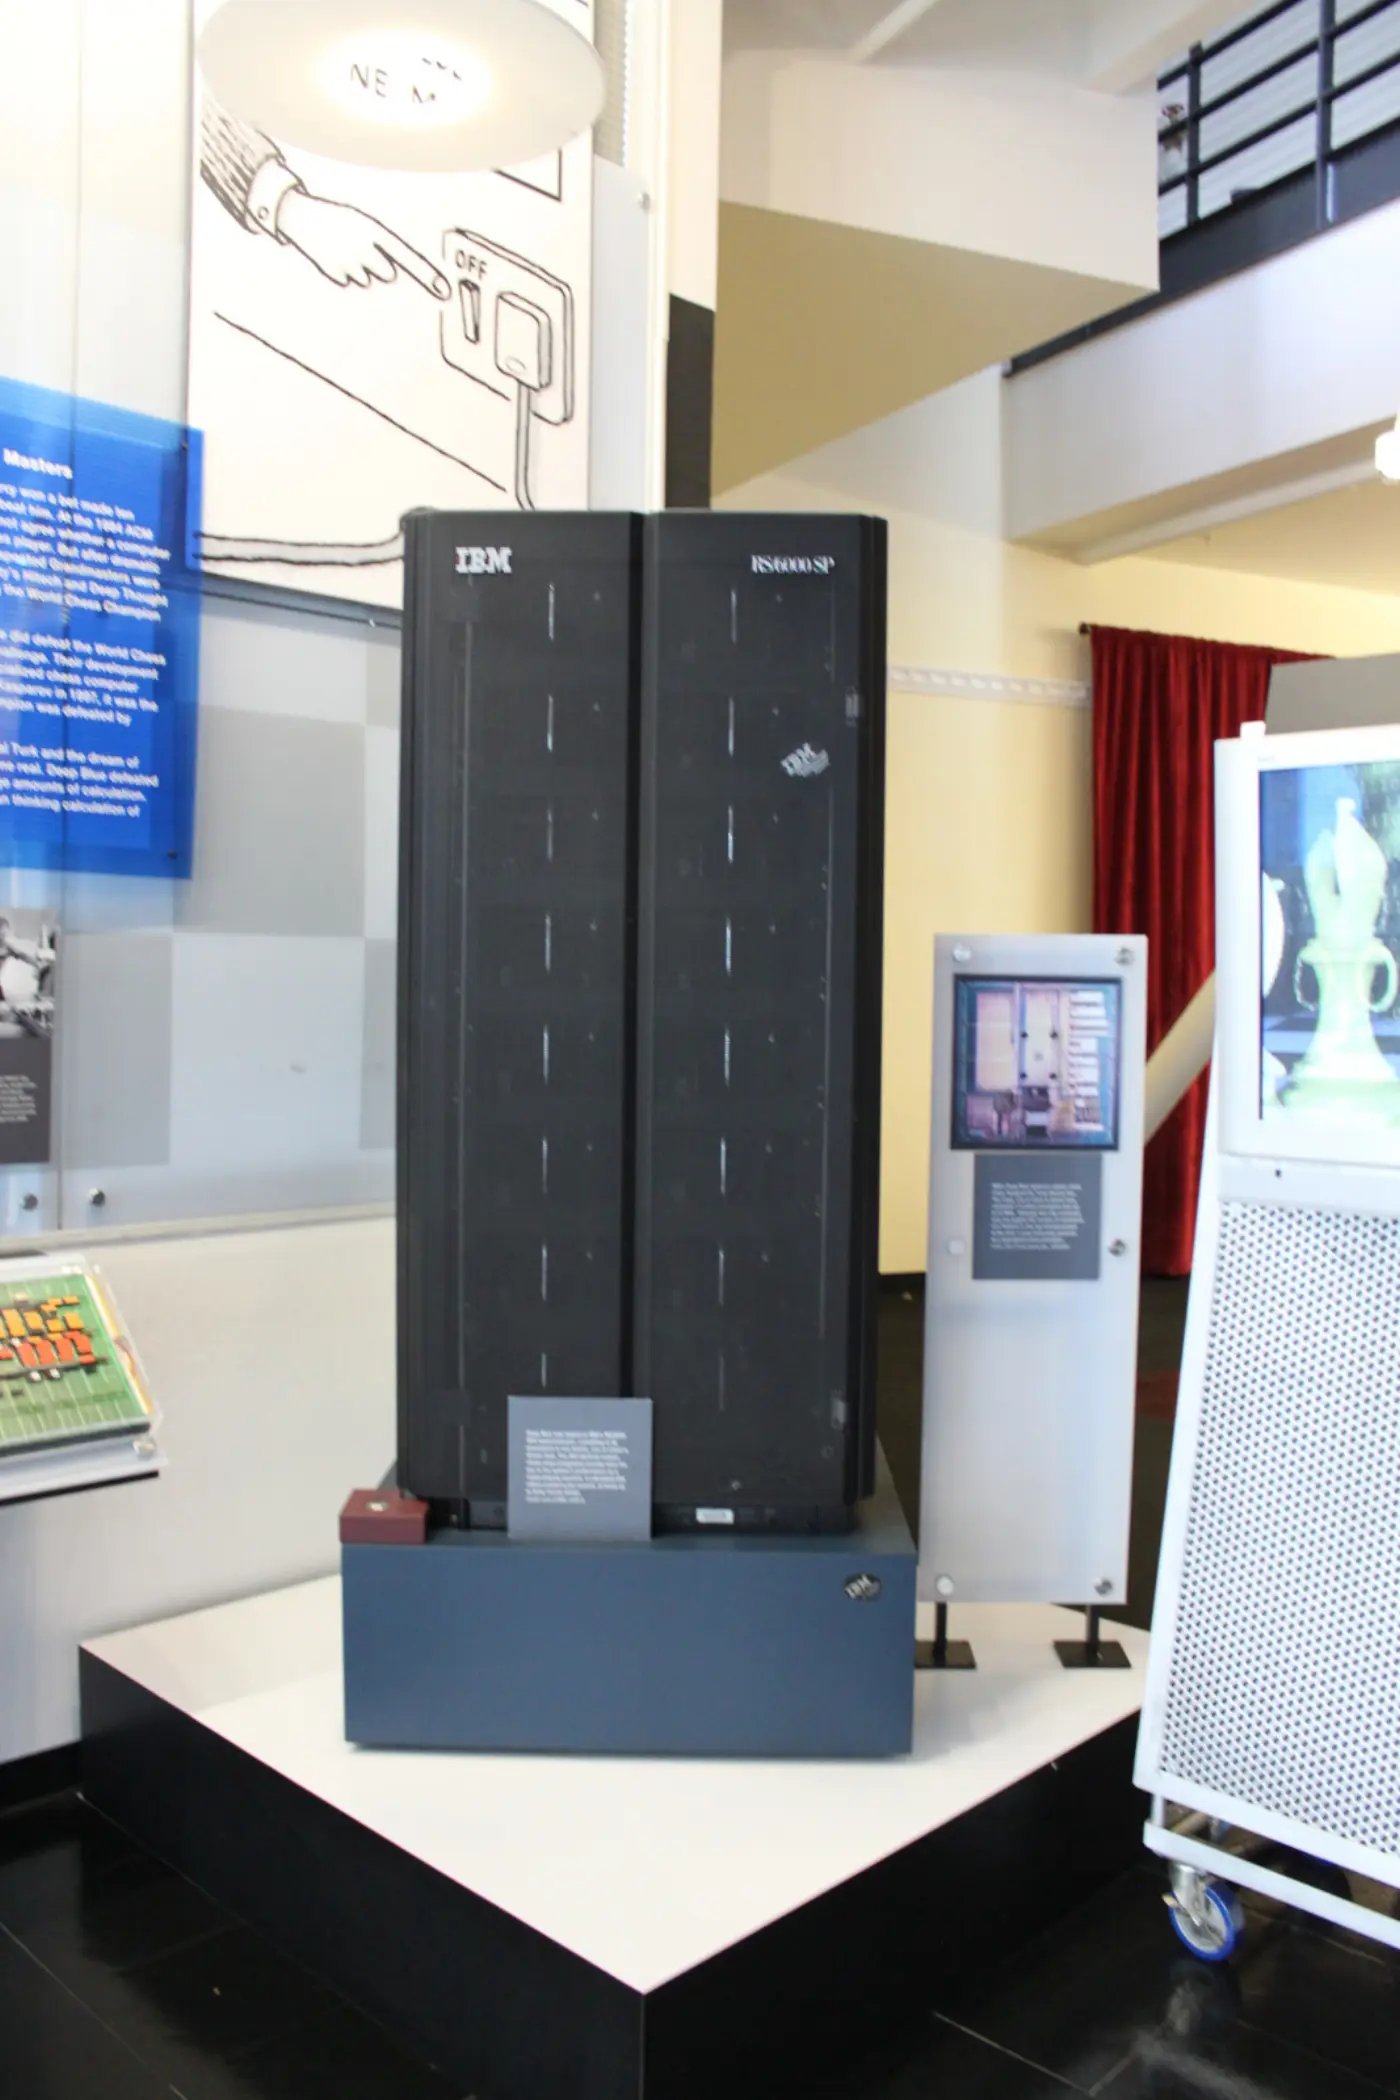
미국 컴퓨터역사박물관에 전시된 IBM 딥블루. 1997년 5월 세계 체스 챔피언을 이긴 기계다 · Anton Chiang from Cupertino, CA, USA · CC BY 2.0 · 위키미디어 공용
2012년, 기계가 보는 법을 배우다
다음 전환은 계산이 아니라 학습에서 왔습니다. 2012년 토론토 대학의 알렉스 크리제브스키, 일리야 수츠케버, 제프리 힌턴은 사진 120만 장의 ImageNet 자료로 깊은 합성곱 신경망을 훈련했습니다. 매개변수 6,000만 개, 뉴런 65만 개짜리 신경망이었고, 훈련을 빠르게 하려고 GPU를 썼습니다. 이 모델의 변형은 그해 ILSVRC-2012 대회에서 상위 5개 후보 기준 오류율 15.3%로 우승했습니다. 2위의 오류율은 26.2%였습니다.
숫자만 보면 10.9%포인트 차이지만, 뜻은 그보다 큽니다. 사람이 "고양이는 귀가 뾰족하다"고 규칙을 적어 주지 않아도, 기계가 사진을 많이 보고 스스로 특징을 찾아낼 수 있다는 것이 큰 차이로 드러난 해였습니다. 오늘날 사진 속 얼굴을 찾고, 의료 영상을 읽고, 자동차가 보행자를 알아보는 기술의 뿌리는 대체로 이 방식에 닿아 있습니다.
2016년 3월, 서울의 바둑판
2016년 3월 9일부터 15일까지 서울 포시즌스 호텔에서 구글 딥마인드의 알파고가 이세돌 9단과 다섯 판을 두었습니다. 결과는 알파고의 4 대 1 승리였습니다. 이세돌은 3월 13일 4국에서 이겼고, 알파고는 그 판에서 돌을 던졌습니다. 딥마인드는 알파고가 두 개의 신경망을 쓴다고 설명합니다. 다음 수를 고르는 정책망과 누가 이길지 예측하는 가치망입니다. 알파고는 먼저 사람 고수의 기보 수천 판으로 배운 뒤, 이전 버전의 자기 자신과 수천 판을 두면서 자기 실수에서 배웠습니다.
알파고는 계산에 학습을 더했고, 사람에게 배운 뒤 사람 없이도 배웠습니다. 한국에서 이 대국이 특별했던 이유는 결과 자체보다, 많은 사람이 생중계로 기계의 수를 지켜보면서 "기계가 무엇을 할 수 있는가"를 처음으로 실감했다는 데 있다고 봅니다. 그리고 4국은 기계도 틀린다는 것을 함께 보여 주었습니다.
2017년의 설계도, 2022년의 대화창
2017년 6월 구글 연구진은 〈Attention Is All You Need〉라는 논문을 공개했습니다. 순환 구조와 합성곱을 모두 버리고 '어텐션'이라는 장치만으로 문장을 처리하는 트랜스포머 구조를 제안한 논문입니다. 영어-독일어 번역 평가에서 28.4 BLEU를 기록해 그때까지의 최고 결과를 2 BLEU 이상 넘어섰고, GPU 8개로 3.5일 훈련한 단일 모델이 영어-프랑스어에서 41.8 BLEU를 냈습니다. 이 구조가 이후 언어 모델의 바탕이 되었습니다.
2022년 11월 30일 OpenAI는 ChatGPT를 '리서치 프리뷰'로 공개했습니다. OpenAI는 이 모델이 2022년 초 훈련을 마친 GPT-3.5 계열을 대화에 맞게 다듬은 것이며, 사람의 피드백으로 강화 학습(RLHF)을 했다고 밝혔습니다. 같은 글에서 OpenAI는 한계도 적었습니다. 그럴듯하게 들리지만 틀리거나 터무니없는 답을 쓰는 일이 있고, 같은 질문을 조금 바꾸면 답이 달라지며, 해로운 지시에 응답할 수도 있다는 내용입니다. 이 공개 뒤로 대화형 AI는 연구실 밖의 일상 도구가 되었습니다.
저는 이 한계 목록이 발표문에서 가장 중요한 대목이라고 봅니다. 도구를 내놓는 쪽이 "이 도구는 이런 식으로 틀린다"고 적어 둔 것이기 때문입니다. 망치 설명서에 "못 머리가 아닌 손가락을 칠 수 있다"고 적어 두는 일과 같습니다. 쓰는 사람이 그 줄을 읽었느냐가 결과를 가릅니다.
사람에게 도움이 된 장면 1: 단백질 2억 개의 모양
발전의 역사가 게임과 대화로만 남았다면 이 글을 쓰지 않았을 것입니다. 2020년 딥마인드의 데미스 허사비스와 존 점퍼는 알파폴드2를 발표했습니다. 아미노산 배열로 단백질의 3차원 구조를 예측하는 모델입니다. 1970년대부터 연구자들이 풀려고 애쓴 문제였습니다. 2021년 7월 딥마인드와 유럽분자생물학연구소(EMBL-EBI)는 예측 구조 35만 개로 공개 데이터베이스를 열었고, 2022년 7월에는 2억 개가 넘는 구조로 확장했습니다. 유전체가 해독된 거의 모든 생물의 단백질을 아우르는 규모입니다. 구조는 CC BY 4.0 라이선스로 누구나 쓸 수 있고, 확장 발표 시점에 190개국이 넘는 나라의 연구자 50만 명 이상이 이 데이터베이스를 썼으며 1년 남짓 사이에 1,000편이 넘는 논문이 인용했습니다.
2024년 10월 9일 스웨덴 왕립과학원은 노벨 화학상의 절반을 허사비스와 점퍼에게 '단백질 구조 예측'으로, 나머지 절반을 데이비드 베이커에게 '계산을 이용한 단백질 설계'로 수여한다고 발표했습니다. 발표문은 알파폴드2가 연구자들이 확인한 약 2억 개 단백질의 구조를 거의 모두 예측했고, 190개국에서 200만 명이 넘는 사람이 이를 썼으며, 항생제 내성을 이해하고 플라스틱을 분해하는 효소의 모습을 그리는 데 쓰이고 있다고 적었습니다.
이 사례가 제게 특별한 이유는 도구가 '답'을 준 것이 아니라 '지도'를 주었기 때문입니다. 단백질 구조를 안다고 해서 약이 바로 나오지는 않습니다. 그러나 50년 동안 한 개씩 실험으로 밝히던 모양을 한꺼번에 2억 개 펼쳐 놓으면, 연구자들은 어디를 파야 할지 훨씬 빨리 정할 수 있습니다. 좋은 도구는 일을 대신하기보다 일의 출발점을 앞당깁니다.
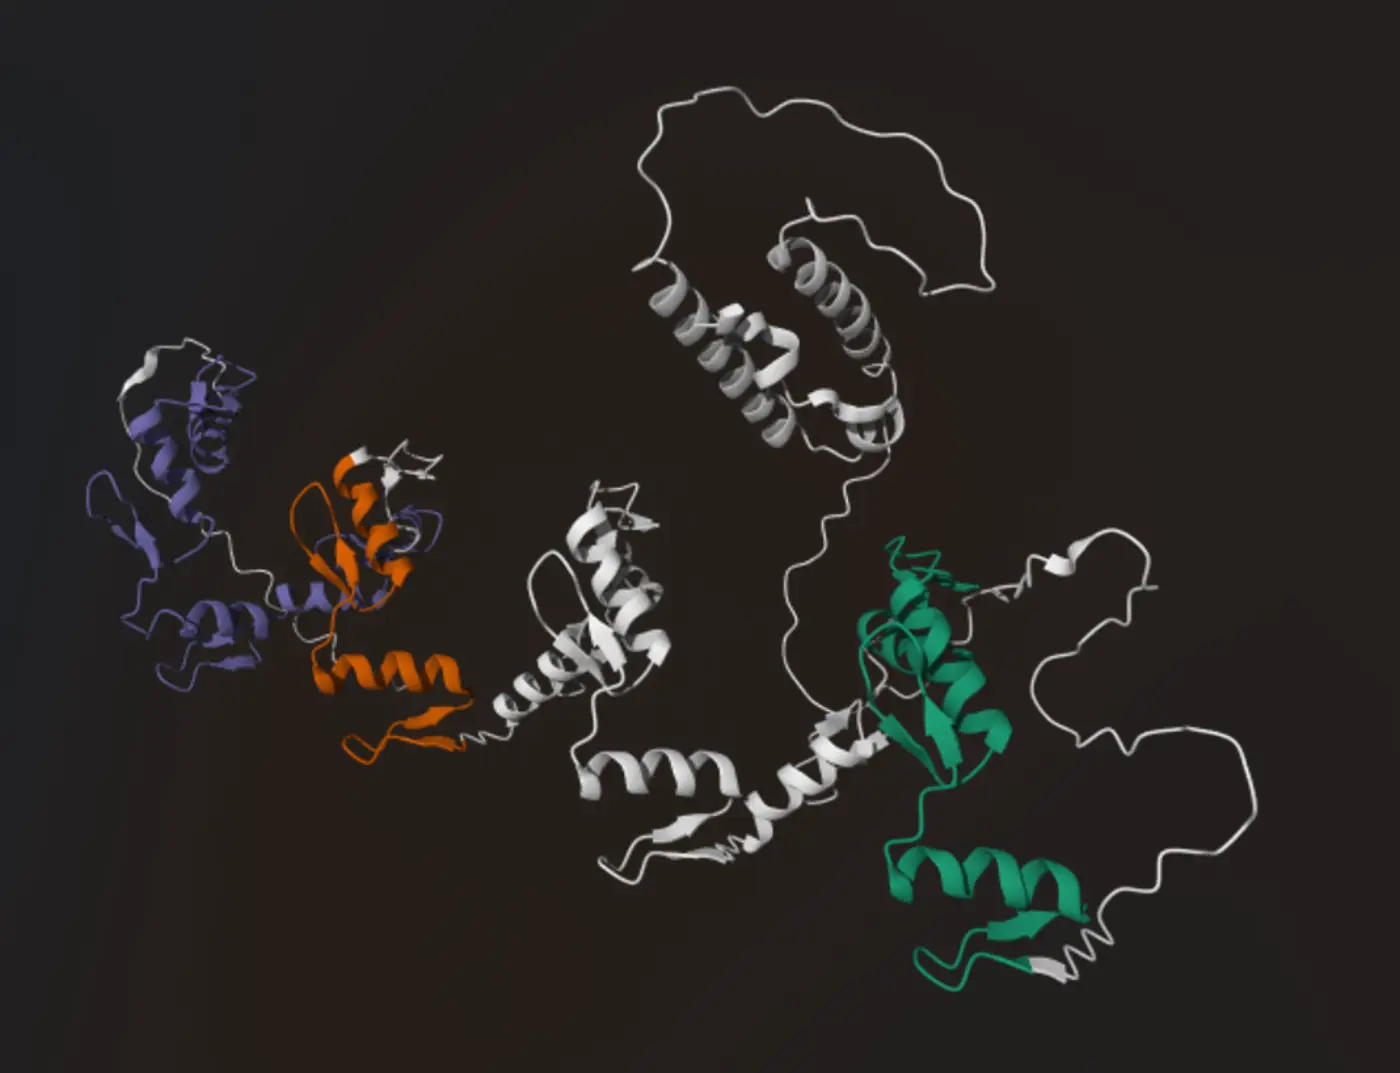
알파폴드 단백질 구조 데이터베이스가 예측한 사람 단백질 ZNF555의 3차원 구조. 실험이 아니라 계산으로 그린 모양이다 · AlphaFold Protein Structure Database (DeepMind / EMBL-EBI) · CC BY 4.0 · 위키미디어 공용
사람에게 도움이 된 장면 2: 전문의 없는 진료실의 눈 검사
2018년 4월 11일 미국 식품의약국(FDA)은 IDx-DR이라는 소프트웨어의 판매를 허가했습니다. 당뇨병 환자의 망막 사진을 인공지능이 분석해, 경증을 넘는 당뇨망막병증이 있으면 "안과 전문의에게 의뢰", 없으면 "12개월 뒤 재검"이라는 두 결과 가운데 하나를 내놓는 장치입니다. FDA는 이것이 임상의가 영상이나 결과를 따로 해석하지 않아도 검진 판정을 내리는, 허가된 첫 장치라고 밝혔습니다. 평소 눈을 보지 않는 1차 진료 의사도 쓸 수 있다는 뜻입니다. FDA가 검토한 임상 연구는 1차 진료 기관 10곳에서 당뇨병 환자 900명의 망막 사진으로 이루어졌고, 장치는 경증을 넘는 병증이 있는 환자를 87.4%, 없는 환자를 89.5% 올바르게 가려냈습니다.
FDA 발표문에는 당뇨병 환자의 약 절반이 해마다 안과를 찾지 않는다는 설명이 함께 실려 있습니다. 이 도구의 가치는 정확도 숫자보다 그 문장에 있다고 봅니다. 안과에 가지 않는 사람의 눈을, 안과가 아닌 곳에서 미리 볼 수 있게 한 것입니다. 동시에 FDA는 쓰면 안 되는 경우도 길게 적었습니다. 임신 중인 환자, 이미 눈 치료를 받은 환자, 다른 망막 질환이 있는 환자에게는 쓰지 말고, 40세와 60세에는 여전히 전체 안과 검진을 받으라는 내용입니다. 도구의 쓰임과 쓰지 말아야 할 자리를 같은 문서에 나란히 적어 둔 것입니다.
석기시대의 돌도끼와 오늘의 도구
스미스소니언 국립자연사박물관의 인류 기원 자료에 따르면 초기 인류는 늦어도 260만 년 전부터 돌로 도구를 만들었습니다. 가장 오래된 도구 묶음인 올도완 석기는 망치돌, 떼어 낸 자국이 남은 몸돌, 날카로운 격지로 이루어집니다. 약 176만 년 전에는 큰 격지를 떼어 낸 뒤 작은 격지를 더 떼어 모양을 다듬은 주먹도끼가 나타났고, 이 아슐리안 도구 묶음은 지역에 따라 40만~25만 년 전까지 쓰였습니다. 비슷한 모양의 돌이 100만 년 넘게 이어진 셈입니다.
돌도끼는 그 자체로 좋은 것도 나쁜 것도 아니었습니다. 같은 날의 같은 돌이 무엇을 했는지는 돌이 아니라 손이 정했습니다. 저는 인공지능도 이 줄 위에 놓고 읽습니다. 1950년의 질문, 1955년의 제안서, 1966년의 규칙, 1997년의 계산, 2012년의 학습, 2016년의 자기 대국, 2017년의 설계도와 2022년의 대화창은 모두 사람이 손에 쥘 새 도구를 깎아 온 과정이었습니다. 단백질 2억 개의 지도와 진료실의 눈 검사는 그 도구가 사람의 목적에 맞게 쓰였을 때 어떤 일이 일어나는지 보여 줍니다.
그래서 이 글의 결론은 기술에 대한 예언이 아니라 사용자에 대한 당부입니다. 도구는 사용 목적에 따라 달라집니다. OpenAI가 스스로 적은 한계 목록과 FDA가 적은 금지 조건은 도구의 결함 고백이 아니라 사용 설명서입니다. 설명서를 읽고 목적을 정하는 일은 여전히 사람의 몫입니다. 260만 년 전 돌을 쥔 손이 그랬던 것처럼, 지금 자판 위에 있는 손이 이 도구로 무엇을 할지를 정합니다.
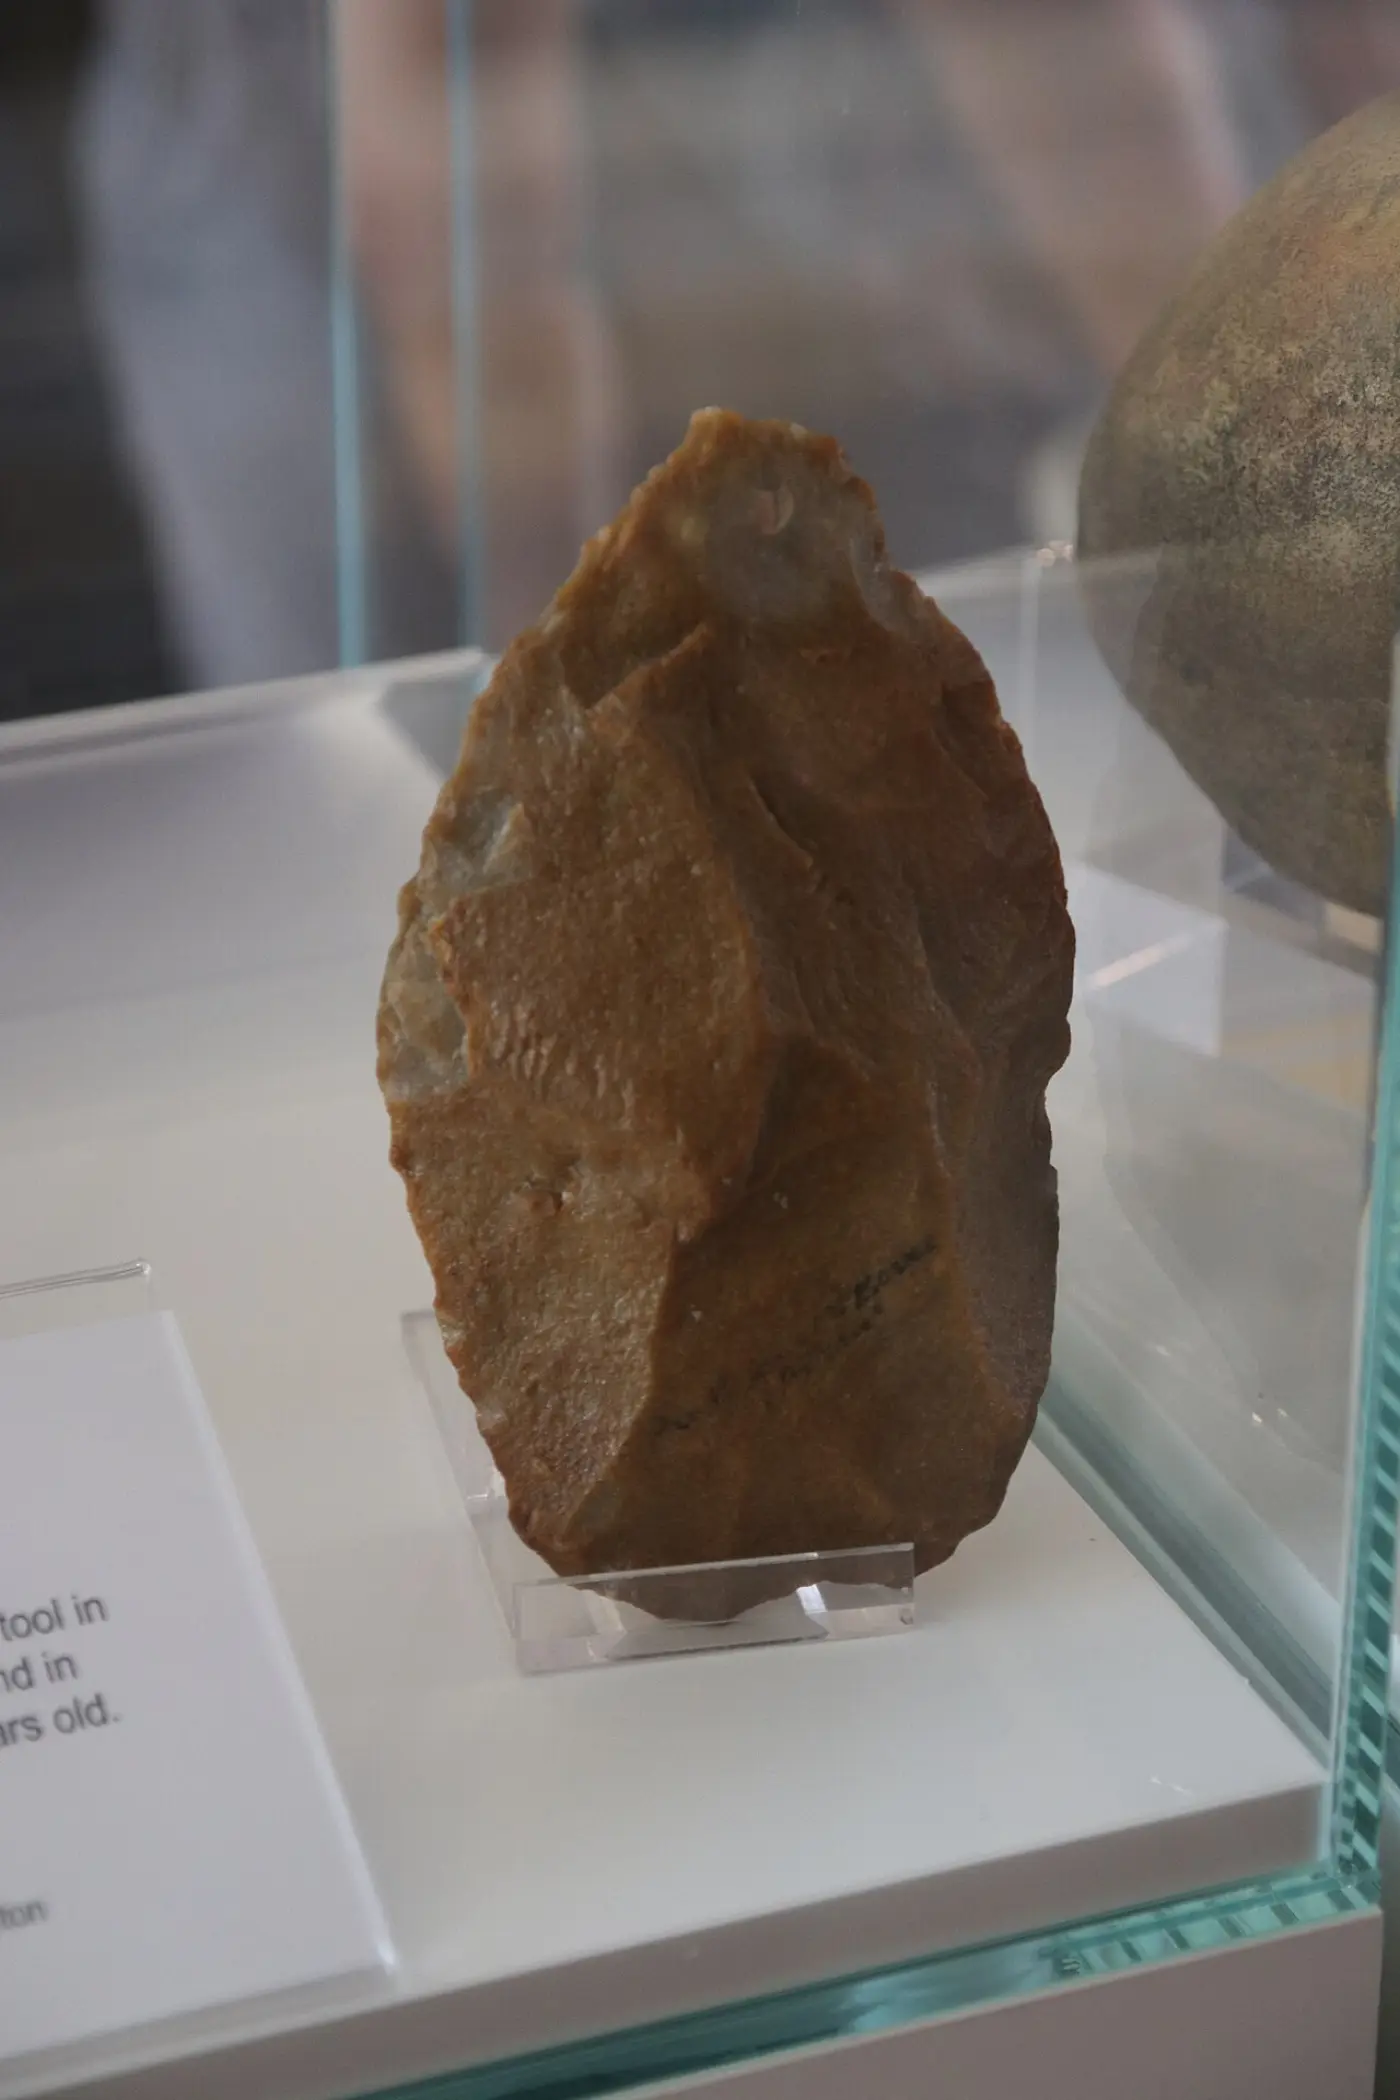
잉글랜드 남부에서 발견된 아슐리안 주먹도끼. 큰 격지를 떼어 낸 뒤 가장자리를 다듬은 모양이다 · Tim Sheerman-Chase · CC BY 4.0 · 위키미디어 공용